Qué dice la gráfica de Syndrome
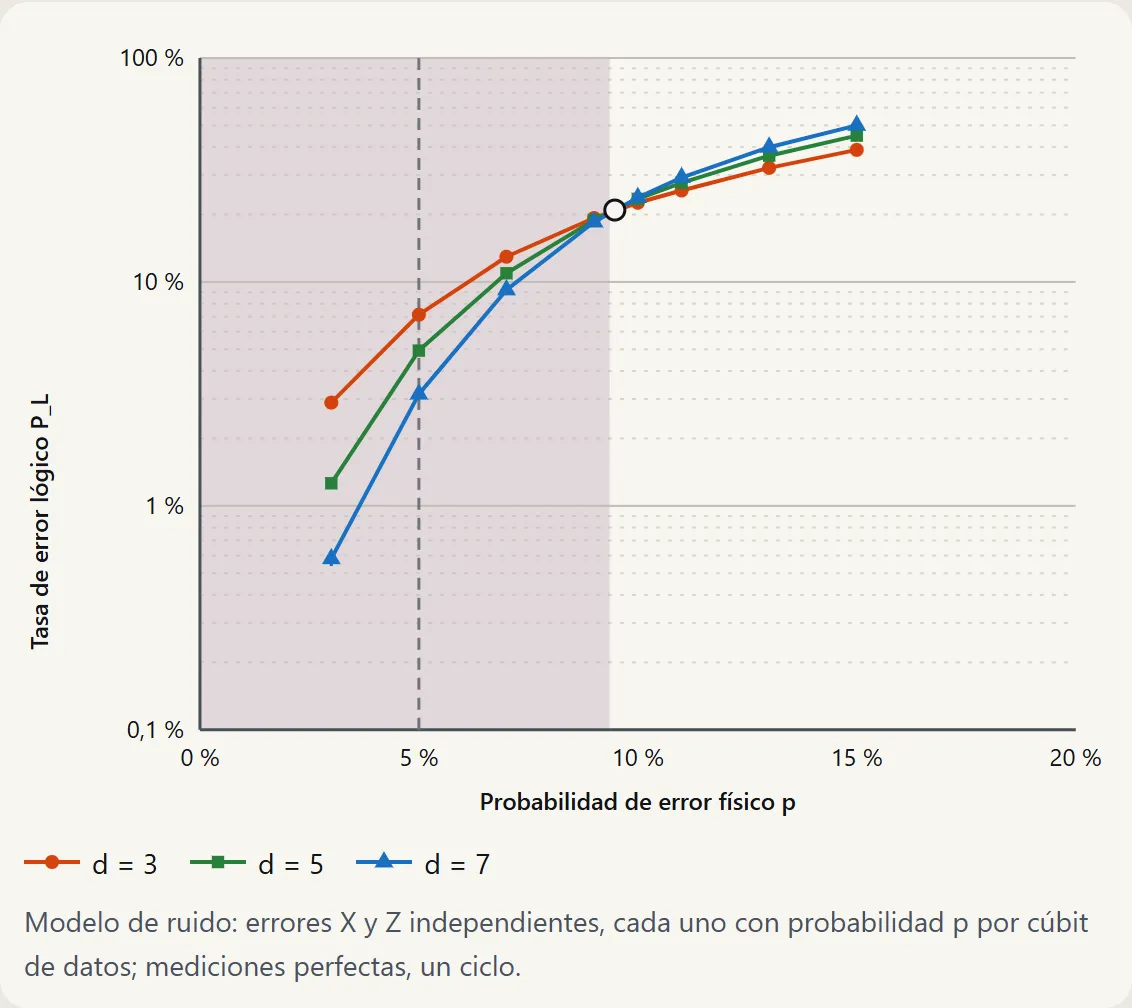
La gráfica de Syndrome resume en una imagen por qué funciona la corrección de errores cuánticos: mientras el hardware falle menos que un umbral, un código más grande comete menos errores lógicos.
Qué se dibuja
- Eje horizontal:
p, la probabilidad de error físico: cada cúbit de datos sufre un error X con probabilidadpy, de forma independiente, un error Z con probabilidadp(con ruido fenomenológico, además, cada medición falla con esa mismap). - Eje vertical:
P_L, la fracción de tiradas simuladas que acaban en un error lógico, es decir, en las que la corrección no consigue proteger la información. La escala es logarítmica: en lineal, las diferencias que importan, por debajo de unos pocos puntos, no se verían. - Una curva por distancia del código de superficie rotado: d = 3, 5 y 7 (9, 25 y 49 cúbits de datos). Cada punto lleva su intervalo de confianza de Wilson al 95 %.
Cómo se lee
A la izquierda del cruce, el hardware es lo bastante bueno: la curva de d = 7 queda por debajo de la de d = 5, y ésta por debajo de la de d = 3. Añadir cúbits reduce los errores lógicos. Por ejemplo, con ruido independiente y p = 5 %, la simulación de referencia mide una tasa de error lógico de 7,122 % con d = 3, de 4,856 % con d = 5 y de 3,141 % con d = 7, con 10⁵ tiradas por punto.
A la derecha del cruce pasa lo contrario: cada cúbit añadido aporta más ocasiones de fallar que capacidad de corregir, y el código grande sale peor. El punto donde se cruzan las curvas es la estimación del umbral para estos tamaños.
Dónde se cruzan las curvas
Depende del modelo de ruido. Syndrome tiene dos.
Ruido independiente X/Z, mediciones perfectas. Cada cúbit de datos sufre un error X con
probabilidad p y, por separado, un error Z con probabilidad p; las mediciones no fallan. El
umbral asintótico del decodificador de emparejamiento perfecto de peso mínimo (MWPM) con este
modelo es ≈10,3 % (Wang, Harrington y Preskill, 2003). Con d = 3, 5 y 7 el cruce no cae
exactamente ahí, por el tamaño finito y los bordes del código: se espera entre el 9 % y el 11 %. En
la simulación de referencia, las tres parejas de curvas se cruzan en el tramo de la malla que va
del 9 % al 10 %.
Ruido fenomenológico: las mediciones también fallan. Durante d ciclos, los cúbits de datos
acumulan errores y cada medición de un estabilizador se invierte con la misma probabilidad p. El
umbral asintótico es ≈2,9 % (Wang, Harrington y Preskill). Para estos tamaños, los cruces medidos
caen por debajo y dependen de la pareja de curvas: (3, 5) ≈ 2,25 %, (3, 7) ≈ 2,50 % y
(5, 7) ≈ 2,85 %.
Los cruces se estiman interpolando entre los puntos de una malla: orientan, no fijan el umbral a décimas.
Willow, como contexto
En el experimento Willow (Google Quantum AI, Nature, 2025), la tasa de error lógico por ciclo bajó al pasar de d = 3 a d = 5 y a d = 7. Ajustando esas tres distancias, el artículo da un factor de supresión Λ ≈ 2,14: la reducción por salto de distancia que mejor describe las tres medidas, no un cociente medido salto a salto. Es hardware real, con un modelo de ruido distinto de los de Syndrome: la cifra sirve de contexto, no es algo que Syndrome reproduzca.
Fuentes
- Informe de validación de Syndrome, generado el 17 de octubre de 2026: referencia con PyMatching 2.4.0, y Stim 1.16.0 para el modelo fenomenológico. El repositorio de Syndrome no es público por ahora.
- Convenciones físicas de Syndrome (geometría del código, pesos del decodificador y modelos de ruido), fijadas en el repositorio de Syndrome, versión del 19 de octubre de 2026.
- C. Wang, J. Harrington y J. Preskill, «Confinement-Higgs transition in a disordered gauge theory and the accuracy threshold for quantum memory», Annals of Physics 303, 31 (2003).
- Google Quantum AI, «Quantum error correction below the surface code threshold», Nature 638, 920–926 (2025).
Cómo se comparan Syndrome y la referencia: Método.